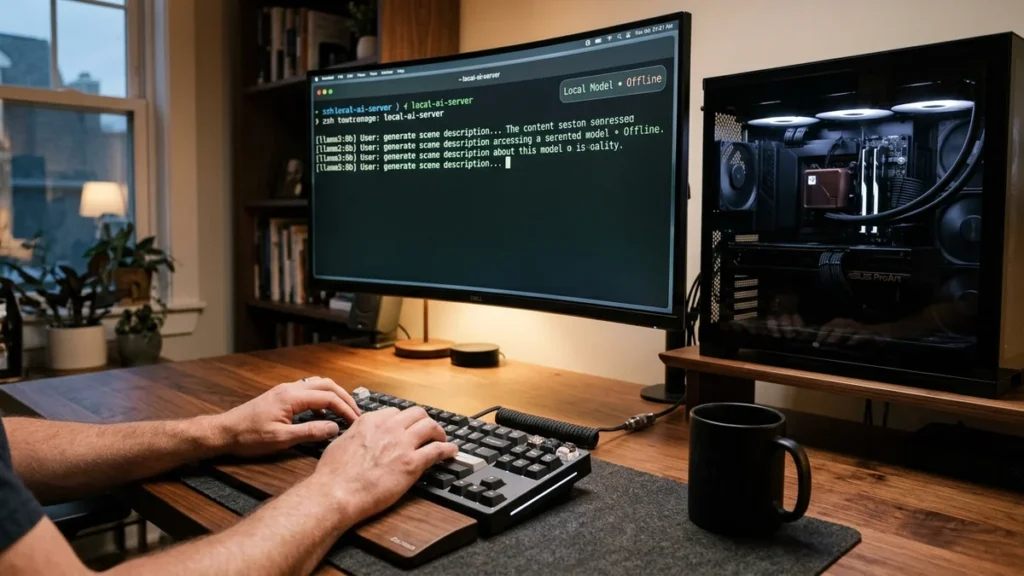
- Herramientas de código abierto permiten ejecutar modelos de lenguaje avanzados en computadoras personales sin conexión.
- Plataformas como Ollama y LM Studio facilitan la descarga y parametrización de asistentes en minutos.
- La ejecución local garantiza absoluta privacidad al evitar que las consultas sean transmitidas a servidores en la nube.
- El rendimiento depende de la memoria unificada del sistema y la potencia de cálculo de tarjetas gráficas dedicadas.
- Especialistas recomiendan modelos optimizados de siete mil millones de parámetros para equipos de gama media.
La evolución acelerada del software libre y la optimización de los pesos algorítmicos han hecho posible lo que hace pocos años parecía exclusivo de los supercomputadores: ejecutar una inteligencia artificial en tu PC con fluidez, alta precisión y sin requerir conexión a internet. Esta modalidad de procesamiento local ha ganado una enorme popularidad entre profesionales, programadores y usuarios preocupados por la confidencialidad de sus datos personales y corporativos.
Ventajas de ejecutar una inteligencia artificial en tu PC
A diferencia de los servicios tradicionales en la nube como ChatGPT o Claude, donde cada texto, documento o código enviado es procesado y almacenado en centros de datos remotos, contar con una inteligencia artificial en tu PC garantiza que las consultas permanezcan estrictamente confinadas en el disco duro del usuario. Esta privacidad absoluta resulta indispensable para procesar historiales médicos, balances financieros o propiedad intelectual sin riesgo de filtraciones externas.
Además de la soberanía digital, el despliegue local elimina los costos recurrentes de suscripciones mensuales y permite continuar trabajando en entornos remotos, vuelos comerciales o zonas con cobertura de red deficiente. El avance se complementa con la rápida adopción de nuevos modelos de inteligencia artificial de código abierto desarrollados por laboratorios comunitarios y consorcios académicos internacionales.
Esta versatilidad ha incentivado a desarrolladores y empresas a crear flujos de trabajo autónomos donde múltiples modelos pequeños cooperan entre sí en una misma máquina, resolviendo tareas especializadas de análisis de datos y redacción sin requerir infraestructura externa de servidores.
Requisitos de hardware y herramientas de instalación recomendadas
Para implementar estos sistemas con éxito, el usuario debe verificar que su ordenador cuente con las especificaciones técnicas adecuadas. Para modelos ligeros y eficientes como Llama 3 de 8B o Mistral 7B, se recomienda disponer de al menos 16 GB de memoria RAM y, de preferencia, una tarjeta gráfica dedicada con 8 GB o más de memoria VRAM (Nvidia RTX o chips Apple Silicon con memoria unificada).
Entre las aplicaciones más accesibles y potentes destacan:
- Ollama: Una herramienta de línea de comandos extraordinariamente ligera que permite descargar y servir modelos locales en Windows, macOS y Linux con un solo comando.
- LM Studio: Una interfaz gráfica elegante e intuitiva que permite buscar modelos en repositorios públicos como Hugging Face, ajustar la temperatura de respuesta y chatear de forma idéntica a una aplicación de mensajería moderna.
- Jan: Una alternativa open source enfocada en la facilidad de uso y la compatibilidad con extensiones de productividad personal.
La comunidad de código abierto nucleada en plataformas como GitHub y Hugging Face actualiza a diario versiones cuantizadas en formato GGUF, las cuales reducen drásticamente el consumo de memoria sin degradar la coherencia lingüística de las respuestas.
El ecosistema de modelos de código abierto ha demostrado una velocidad de innovación comparable e incluso superior a las soluciones privativas de grandes corporaciones, permitiendo a investigadores independientes auditar los datos de entrenamiento y eliminar sesgos algorítmicos con total libertad técnica.
A mediano plazo, la generalización de la computación neuronal en el borde (Edge AI) transformará los sistemas operativos cotidianos, integrando asistentes inteligentes que operan en segundo plano de manera continua sin consumir ancho de banda de red ni comprometer la telemetría del equipo.
Configuración paso a paso para un rendimiento óptimo
El proceso de instalación es sumamente sencillo: basta con descargar el instalador oficial de la plataforma elegida, seleccionar un modelo compatible con la memoria disponible y descargar el archivo de pesos. Una vez completada la descarga inicial, el usuario puede desconectar el cable de red o apagar el Wi-Fi y verificar que el asistente responde preguntas complejas, resume textos extensos y traduce documentos con absoluta rapidez.
De acuerdo con la guía especializada publicada por Infobae, dar el salto hacia los modelos locales representa una democratización tecnológica trascendental que devuelve a los usuarios el control absoluto sobre sus herramientas informáticas más avanzadas.