- Nokia Bell Labs liberó AnyJev bajo licencia comunitaria Apache-2.0 en PyPI.
- Convierte modelos abiertos en sistemas de decisión precisa sin reentrenar parámetros.
- Corrige distorsiones asociadas al orden de las opciones y calibra la confianza real.
- Ofrece compatibilidad inmediata con frameworks de inferencia como vLLM y Transformers.
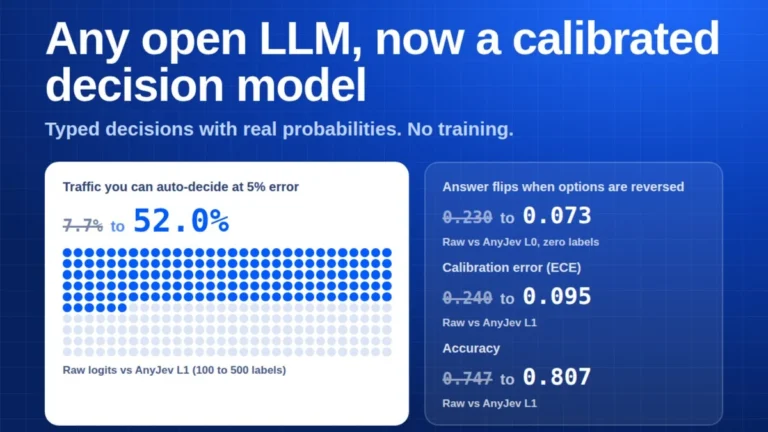
El laboratorio de investigación aplicada de Nokia oficializó el lanzamiento de AnyJev, una biblioteca de código abierto en lenguaje Python que permite convertir cualquier modelo de lenguaje de pesos abiertos (LLM) en un sistema de decisión probabilística calibrada. La herramienta no requiere procesos de ajuste fino ni reentrenamiento de matrices neuronales, solucionando una necesidad frecuente en entornos productivos: seleccionar una alternativa categórica dentro de un listado cerrado con una probabilidad real y comprobable de acierto.
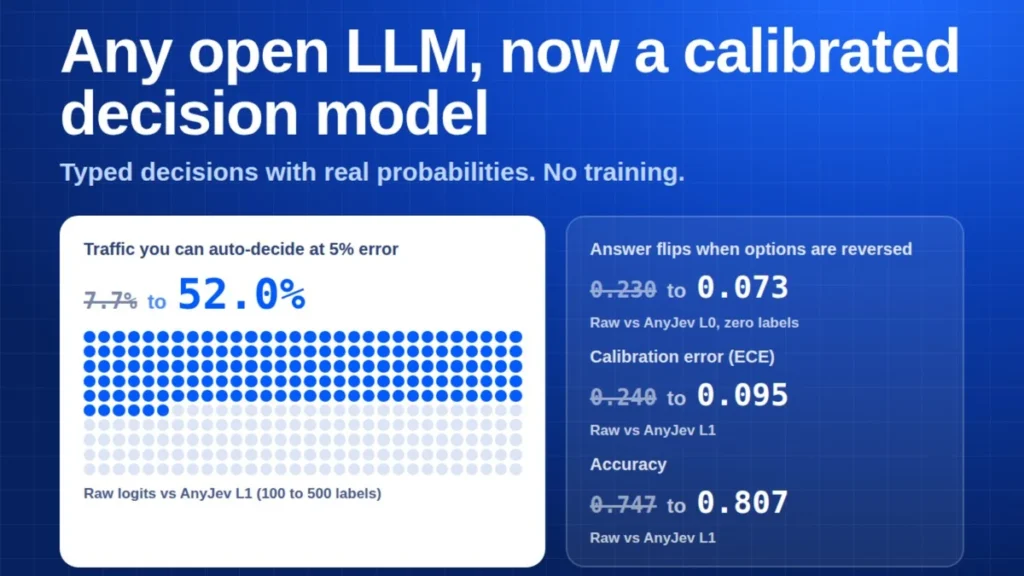
En aplicaciones corporativas, los desarrolladores suelen forzar a los modelos a generar respuestas extensas para luego extraer la opción mediante filtros, un método vulnerable a alucinaciones. Otros recurren a restringir el siguiente token a letras como A o B, pero los investigadores de Nokia recalcan que este procedimiento presenta dos defectos graves: la elección suele cambiar si se barajan las opciones y las puntuaciones no reflejan la certidumbre matemática real de la predicción.
Niveles de ajuste L0 y L1 para decisiones confiables
AnyJev implementa dos modos de trabajo según la disponibilidad de datos de referencia. El modo base L0 (activo de fábrica y sin requerir ejemplos anotados) evalúa las combinaciones posicionales de las alternativas mediante prefijos compartidos en motores de inferencia acelerada, mitigando el sesgo del modelo con un tiempo de procesamiento promedio de 0,25 segundos por consulta en hardware especializado.
Por su parte, el nivel L1 emplea entre 100 y 500 datos de validación para aplicar un escalado de temperatura estadística que calibra las curvas de probabilidad sin alterar la jerarquía de respuestas. El ajuste resultante se almacena en un archivo JSON ultraliviano, garantizando que un pronóstico con 90 % de confianza matemática equivalga a una tasa real de acierto del 90 % en producción.
Integración abierta y estandarización tecnológica
La librería se encuentra disponible en el índice oficial PyPI bajo el régimen de licencias de la Apache Software Foundation, facilitando su adopción sin regalías en infraestructuras corporativas o proyectos universitarios. Su código interactúa de forma fluida con entornos como vLLM y Hugging Face Transformers.
Investigadores de Nokia Bell Labs explicaron que esta solución dota de fiabilidad determinista a procesos de clasificación sensible en ciberseguridad, análisis crediticio y telecomunicaciones. En una coyuntura donde crece la inversión en desarrollo de software y cómputo distribuido, AnyJev establece un puente práctico entre la flexibilidad del procesamiento de lenguaje natural y el rigor matemático requerido en decisiones automatizadas de misión crítica.
Seguridad de procesos y reducción de costos operativos
Uno de los mayores atractivos prácticos de AnyJev es su capacidad para operar sobre modelos ya desplegados sin incurrir en costos de reentrenamiento. Al evitar el ajuste de parámetros en centros de datos, las empresas ahorran miles de horas de procesamiento en GPU, al tiempo que mitigan el riesgo de provocar olvido catastrófico en otras habilidades cognitivas del modelo base.
La biblioteca resuelve de forma elegante el dilema de confiabilidad en auditorías tecnológicas. Los responsables de cumplimiento normativo pueden constatar empíricamente la curva de calibración de cada clasificación, facilitando la homologación de sistemas de inteligencia artificial en industrias como la banca, los seguros y el diagnóstico por imágenes.
Asimismo, en entornos de cómputo en la nube, el ahorro derivado de sustituir generaciones largas por decisiones calibradas de token único disminuye la huella energética de los centros de procesamiento. La propuesta de Nokia Bell Labs evidencia que la optimización estadística y el diseño inteligente de capas intermedias pueden generar más valor que el simple incremento indiscriminado del tamaño de los modelos.